W jądrze Linux pojawiła się obiecująca zmiana w obsłudze pamięci, która pokazuje, jak wiele można zyskać dzięki pozornie niewielkiej poprawie algorytmu. Inżynier Google, Tarun Sahu, zaproponował wykorzystanie wyszukiwania binarnego w mechanizmie memblock. W jednym z testowanych scenariuszy czas odzyskiwania informacji o pamięci w ramach Kernel Handover spadł z około 268 sekund do zaledwie 50 milisekund.
To nie jest uniwersalne przyspieszenie uruchamiania każdego komputera z Linuksem. Zmiana celuje w konkretny problem, który ujawnia się przy bardzo dużej liczbie rozproszonych obszarów pamięci fizycznej. Jej znaczenie może być jednak duże dla infrastruktury serwerowej, środowisk wirtualizacyjnych oraz mechanizmów odpowiedzialnych za zachowanie stanu pamięci podczas aktualizacji systemu.
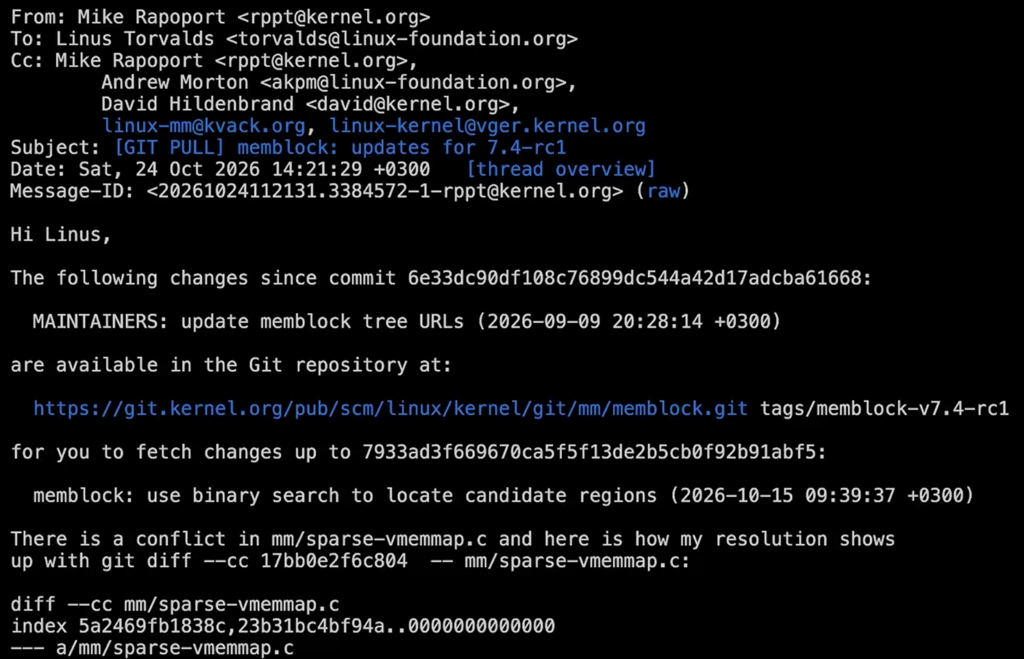
memblock – mechanizm działający, zanim ruszy właściwy alokator pamięci
Aby zrozumieć wagę tej optymalizacji, trzeba najpierw przyjrzeć się architekturze zarządzania pamięcią w jądrze Linux.
Podczas uruchamiania systemu jądro musi poznać układ dostępnej pamięci fizycznej, ustalić, które jej fragmenty są wolne, a które zostały już zarezerwowane, oraz przygotować środowisko do dalszej inicjalizacji. Nie może od razu polegać na wszystkich mechanizmach zarządzania pamięcią, które będą dostępne po zakończeniu tego procesu.
Do tego celu służy memblock – wczesny mechanizm zarządzania obszarami pamięci fizycznej.
Jego implementacja znajduje się w pliku:
mm/memblock.c
W uproszczeniu memblock przechowuje informacje o regionach pamięci, opisując je za pomocą adresu początkowego i rozmiaru. Dzięki temu jądro może wykonywać operacje takie jak:
- dodawanie nowych obszarów pamięci;
- rejestrowanie obszarów zarezerwowanych;
- wydzielanie fragmentów regionów;
- wyszukiwanie obszarów obejmujących określone adresy fizyczne.
Ważne jest to, że regiony są uporządkowane według adresów. To właśnie ta właściwość umożliwia zastosowanie wyszukiwania binarnego.
Problem nie ujawnia się zwykle przy kilku lub kilkudziesięciu regionach. Zaczyna być dotkliwy, gdy system musi obsługiwać setki tysięcy osobnych fragmentów pamięci.
Na czym polega problem z dotychczasowym kodem?
Optymalizacja przygotowana przez Taruna Sahu dotyczy przede wszystkim dwóch funkcji:
memblock_add_range()– dodawania i łączenia regionów pamięci;memblock_isolate_range()– wydzielania fragmentu pamięci poprzez odpowiednie podzielenie lub odseparowanie regionów.
W pierwotnym podejściu funkcje te mogły przeglądać tablicę regionów liniowo, rozpoczynając od jej pierwszego elementu. Oznacza to, że nawet jeśli poszukiwany obszar znajdował się pod koniec uporządkowanej tablicy, kod musiał wcześniej przejść przez wiele nieistotnych wpisów.
Przy małej liczbie elementów nie stanowi to problemu. Przy dużej fragmentacji pamięci sytuacja wygląda jednak zupełnie inaczej.
Załóżmy, że mechanizm musi obsłużyć około 393 tysięcy rozproszonych stron pamięci. Jeśli kolejne operacje wielokrotnie skanują tablicę od początku, łączna liczba sprawdzeń może rosnąć kwadratowo względem liczby regionów.
Dla (N) regionów uproszczony model kosztu takiego przetwarzania może wyglądać następująco:
[
T(N) = O(N^2)
]
To oznacza, że dwukrotne zwiększenie liczby regionów może w najgorszym przypadku prowadzić do około czterokrotnego wzrostu kosztu operacji.
W praktyce wydajność zależy od układu regionów, liczby operacji oraz sposobu ich wstawiania i izolowania. Nie każda sekwencja operacji osiąga koszt kwadratowy, ale powtarzanie pełnych skanów przy silnej fragmentacji jest szczególnie niekorzystne.
Wyszukiwanie binarne zamiast skanowania od początku
Pomysł Taruna Sahu polega na wykorzystaniu istniejącego porządku regionów do ustalenia miejsca, od którego faktycznie należy rozpocząć przeglądanie tablicy.
Nowa funkcja pomocnicza w proponowanym rozwiązaniu nosi nazwę:
memblock_bsearch_start()
Jej zadaniem jest znalezienie indeksu pierwszego regionu, którego koniec znajduje się za adresem początkowym poszukiwanego zakresu.
Dla każdego regionu można zdefiniować:
base– początkowy adres fizyczny;size– rozmiar regionu;rend = base + size– adres końca regionu w konwencji przedziału półotwartego.
Szukamy pierwszego regionu, dla którego:
[
rend > search_base
]
Jeżeli koniec regionu znajduje się przed początkiem poszukiwanego zakresu lub dokładnie na jego granicy, region nie może go obejmować. Można więc przejść do kolejnej części uporządkowanej tablicy.
Jak działa algorytm?
- Ustalamy dolną i górną granicę wyszukiwania.
- Obliczamy indeks środkowego elementu.
- Sprawdzamy koniec regionu znajdującego się pod tym indeksem.
- Jeżeli region kończy się przed poszukiwanym adresem lub na nim, kontynuujemy wyszukiwanie w prawej części tablicy.
- W przeciwnym razie zawężamy obszar poszukiwań do lewej części.
- Powtarzamy operację, aż otrzymamy indeks pierwszego potencjalnie istotnego regionu.
Zamiast sprawdzać setki tysięcy wpisów po kolei, algorytm eliminuje mniej więcej połowę pozostałego obszaru poszukiwań w każdym kroku.
Przykładowo, dla 393 tysięcy elementów wyszukiwanie binarne wymaga około 19 porównań w typowym przypadku dla samego znalezienia pozycji. To ogromna różnica w stosunku do liniowego skanowania, które może wymagać setek tysięcy porównań.
Analiza kodu: memblock_bsearch_start()
Poniższy fragment przedstawia istotę funkcji z proponowanej zmiany:
static int __init_memblock
memblock_bsearch_start(struct memblock_type *type,
                       phys_addr_t base)
{
    int mid, low = 0;
    int high = type->cnt;

    if (type->cnt &&
        base >= type->regions[type->cnt - 1].base +
                type->regions[type->cnt - 1].size)
        return type->cnt;

    while (low < high) {
        mid = (low + high) / 2;

        if (type->regions[mid].base +
            type->regions[mid].size <= base)
            low = mid + 1;
        else
            high = mid;
    }

    return low;
}
Przyjrzyjmy się najważniejszym elementom.
1. Ustalenie zakresu wyszukiwania
int mid, low = 0;
int high = type->cnt;
low i high wyznaczają zakres indeksów, w którym może znajdować się odpowiedź.
Istotny jest fakt, że high początkowo odpowiada liczbie regionów, a nie indeksowi ostatniego regionu. Algorytm traktuje górną granicę jako wyłączną, co pozwala również zwrócić type->cnt, gdy żaden istniejący region nie jest kandydatem.
2. Szybka ścieżka dla dopisywania na końcu
if (type->cnt &&
    base >= type->regions[type->cnt - 1].base +
            type->regions[type->cnt - 1].size)
    return type->cnt;
To jeden z istotniejszych szczegółów optymalizacji.
Jeśli lista nie jest pusta, a poszukiwany adres znajduje się za końcem ostatniego regionu lub dokładnie na jego granicy, nie trzeba wykonywać pełnego wyszukiwania binarnego. Wystarczy zwrócić indeks końca tablicy.
Ten przypadek jest szczególnie korzystny przy sekwencyjnym dopisywaniu kolejnych regionów. Dzięki niemu powtarzane wyszukiwanie pozycji może mieć łączny koszt liniowy, zamiast logarytmicznego kosztu dla każdego dopisania.
3. Właściwe wyszukiwanie binarne
while (low < high) {
    mid = (low + high) / 2;

    if (type->regions[mid].base +
        type->regions[mid].size <= base)
        low = mid + 1;
    else
        high = mid;
}
Warunek porównania wykorzystuje koniec regionu, a nie tylko jego początek.
To ważne, ponieważ poszukiwany adres może znajdować się wewnątrz regionu. Algorytm ma odnaleźć pierwszy region, którego koniec przekracza poszukiwany adres, a nie po prostu pierwszy region o bazie większej od tego adresu.
Po zakończeniu pętli low wskazuje pierwszy region, który może wymagać sprawdzenia. Pozostała część funkcji dodającej lub izolującej region wykonuje już właściwą pracę na odpowiednim fragmencie tablicy.
4. Dlaczego funkcja zwraca indeks, a nie region?
Zwrócenie indeksu pozwala wykorzystać istniejące mechanizmy przeglądania tablicy. Nie trzeba przebudowywać całej logiki operacji na regionach ani wprowadzać nowej struktury danych.
To jedna z zalet proponowanej zmiany: optymalizacja jest stosunkowo niewielka i koncentruje się na wyeliminowaniu niepotrzebnej pracy.
Złożoność obliczeniowa: gdzie tkwi największy zysk?
Różnicę najlepiej widać w porównaniu kosztu samego wyszukiwania pozycji.
| Właściwość | Skanowanie liniowe | Wyszukiwanie binarne |
|---|---|---|
| Najgorszy koszt znalezienia pozycji | (O(N)) | (O(\log N)) |
| Wykorzystanie uporządkowania regionów | Ograniczone | Pełne |
| Dopisywanie na końcu | Może wymagać skanowania | Stały koszt wyszukania pozycji |
| Powtarzane operacje przy fragmentacji | Mogą prowadzić do (O(N^2)) | Koszt wyszukiwania może spaść do (O(N\log N)) łącznie |
Warto podkreślić jedną rzecz: wyszukiwanie binarne nie sprawia, że każda operacja na tablicy staje się automatycznie logarytmiczna.
Jeżeli dodanie regionu wymaga przesunięcia wielu elementów tablicy, scalenia sąsiadujących obszarów albo rozdzielenia istniejącego zakresu, te operacje nadal mają swój koszt. Optymalizacja usuwa przede wszystkim niepotrzebne skanowanie początkowych, nieistotnych wpisów.
Dlatego prawidłowa interpretacja zmiany jest następująca: koszt wyszukiwania kandydującego regionu spada z (O(N)) do (O(\log N)), a cały ciąg operacji w opisanym scenariuszu może uniknąć dotychczasowego kosztu kwadratowego.
Skąd wzięło się przyspieszenie z 268 sekund do 50 milisekund?
Najbardziej spektakularny wynik dotyczy mechanizmu Kernel Handover (KHO).
KHO jest związany z zachowaniem i przekazywaniem określonego stanu pamięci między instancjami jądra, co może być przydatne w scenariuszach aktualizacji systemu bez tradycyjnego pełnego restartu. W takim środowisku trzeba obsługiwać wiele rozproszonych fragmentów pamięci, które niekoniecznie tworzą jeden ciągły obszar.
W opisie poprawki Tarun Sahu wskazał przypadek rejestrowania setek tysięcy niezależnych stron pamięci. Dla około 393 tysięcy stron odzyskiwanie pamięci w KHO zajmowało około 268 sekund przed optymalizacją.
Po zastosowaniu wyszukiwania binarnego raportowany czas spadł do około 50 milisekund.
| Pomiar w opisanym scenariuszu | Przed optymalizacją | Po optymalizacji |
|---|---|---|
| Odzyskiwanie pamięci KHO | ok. 268 s | ok. 0,05 s |
| Czas w minutach | ok. 4 min 28 s | 0,00083 min |
| Przyspieszenie | — | ok. 5360× |
Są to wyniki zgłoszone przez autora poprawki dla konkretnego obciążenia, a nie gwarantowany wynik dla każdego komputera.
Wartość tego testu polega na pokazaniu, że problem nie musiał wynikać z wolnego sprzętu czy ograniczeń przepustowości pamięci. Znaczną część czasu pochłaniała sama organizacja wyszukiwania regionów.
Właśnie dlatego zmiana algorytmu może dać efekt większy niż optymalizacja pojedynczej instrukcji lub ograniczenie liczby operacji arytmetycznych.
Jakie znaczenie ma to dla zwykłych użytkowników Linuksa?
Najbardziej bezpośrednie korzyści powinny być widoczne w środowiskach, w których występuje duża liczba rozproszonych regionów pamięci i intensywne wykorzystanie mechanizmów KHO.
Może to mieć znaczenie dla:
- infrastruktury serwerowej – szczególnie tam, gdzie ważne są przewidywalne czasy inicjalizacji i operacji związanych z pamięcią;
- środowisk wirtualizacyjnych – w zależności od sposobu wykorzystania pamięci i mechanizmów zachowywania jej stanu;
- aktualizacji systemu i mechanizmów live update – jeżeli proces korzysta z KHO i przetwarza dużą liczbę rozproszonych stron;
- systemów z silnie pofragmentowanym układem regionów – w których wielokrotne skanowanie tablicy staje się kosztowne.
W typowym komputerze stacjonarnym lub laptopie, gdzie podczas startu obsługiwanych jest znacznie mniej regionów, poprawa może być mało zauważalna. Nie należy więc traktować jej jako obietnicy kilkutysięcznego skrócenia czasu startu całego systemu.
To optymalizacja w konkretnym wąskim gardle, a nie ogólna zmiana wszystkich ścieżek zarządzania pamięcią.
Czy zmiana jest bezpieczna?
Sama idea wyszukiwania binarnego jest dobrze znana, ale w kodzie jądra liczy się nie tylko szybkość. Algorytm musi zachować dokładną semantykę granic regionów, prawidłowo obsługiwać puste listy oraz nie pomijać obszarów, które przecinają się z poszukiwanym zakresem.
W przypadku tej poprawki istotne są trzy kwestie.
Po pierwsze: uporządkowanie tablicy. Wyszukiwanie binarne zakłada, że regiony są ułożone w odpowiedniej kolejności i że ich końce pozwalają na monotoniczne podejmowanie decyzji o zawężeniu zakresu. Zmiana musi respektować niezmienniki utrzymywane przez memblock.
Po drugie: granice przedziałów. Warunek rend <= base oznacza, że region kończący się dokładnie w punkcie początkowym nowego zakresu nie jest kandydatem do przecięcia. To zgodne z reprezentacją przedziałów półotwartych, w której koniec nie należy do regionu.
Po trzecie: dalsza obsługa kandydatów. Funkcja wyszukująca nie wykonuje całej operacji dodawania ani izolowania. Zwraca jedynie indeks, od którego istniejący kod ma rozpocząć przeglądanie. Pozostała logika nadal musi prawidłowo rozstrzygnąć nakładanie się zakresów, scalanie i dzielenie regionów.
Proponowana poprawka została rozwijana w kolejnych wersjach, a w publicznej dyskusji pojawiły się uwagi recenzentów dotyczące sposobu wykorzystania istniejącego wyszukiwania w memblock. To normalna część procesu rozwoju jądra: poprawka musi nie tylko działać szybciej, ale też pasować do architektury kodu i zachowywać poprawność w mniej typowych przypadkach.
Co zyskuje Linux dzięki tej optymalizacji?
Najważniejszy wniosek jest prosty: wydajność jądra zależy nie tylko od niskopoziomowych instrukcji i zarządzania sprzętem. Czasami duże znaczenie ma również sposób organizacji danych oraz algorytm używany do znalezienia właściwego elementu.
W tym przypadku uporządkowana tablica regionów pamięci już istniała. Nowością nie jest więc wprowadzenie skomplikowanej struktury danych ani zmiana architektury alokatora. Wystarczyło wykorzystać własność istniejącej struktury, aby uniknąć powtarzania pracy.
To atrakcyjny rodzaj optymalizacji z punktu widzenia utrzymania jądra:
- niewielki zakres zmian w kodzie;
- brak potrzeby wprowadzania nowej struktury danych;
- mniejsza liczba niepotrzebnych odczytów i porównań;
- zachowanie dotychczasowego modelu reprezentowania regionów;
- bardzo duży potencjalny zysk w specyficznych, wymagających scenariuszach.
Nie oznacza to, że wyszukiwanie binarne zawsze będzie lepsze. Dla małych list koszt liniowego przeglądania jest niewielki, a dla operacji modyfikujących tablicę nadal znaczenie mają koszty wstawiania i przesuwania elementów. W tym przypadku szczególnie ważne jest jednak to, że kosztowna ścieżka występuje wielokrotnie przy dużym obciążeniu.
Kiedy możemy spodziewać się tej zmiany?
Wiadomość widoczna na liście rozwojowej jądra z 24 października 2026 r. dotyczy zbioru zmian memblock przygotowanych dla cyklu Linux 7.4, w tym wersji oznaczonej 7.4-rc1.
Oznacza to, że w momencie publikacji omawianego zgłoszenia zmiana była częścią procesu rozwoju i integracji jądra. Nie należy utożsamiać samego zgłoszenia ani przygotowania gałęzi z potwierdzeniem, że dana poprawka znalazła się już w stabilnym wydaniu dystrybucji.
Warto śledzić historię poprawki i ostateczny stan kodu w odpowiednim wydaniu jądra, szczególnie jeśli zależy nam na wykorzystaniu jej w środowisku produkcyjnym.
Podsumowanie
Optymalizacja zaproponowana przez inżyniera Google Taruna Sahu jest dobrym przykładem tego, jak niewielka zmiana algorytmiczna może usunąć poważne wąskie gardło w jądrze Linux.
Zastąpienie powtarzanych skanów liniowych wyszukiwaniem binarnym pozwala szybciej odnaleźć regiony pamięci istotne dla operacji memblock_add_range() i memblock_isolate_range(). W scenariuszu KHO obejmującym około 393 tysięcy stron pamięci autor zgłosił spadek czasu odzyskiwania pamięci z około 268 sekund do 50 milisekund.
Nie jest to przyspieszenie, które każdy użytkownik zauważy podczas codziennego uruchamiania komputera. Jest to jednak wartościowa poprawa dla określonych obciążeń, w których Linux musi zarządzać ogromną liczbą rozproszonych obszarów pamięci.
Najciekawsza lekcja jest szersza: zanim zaczniemy optymalizować pojedyncze instrukcje, warto sprawdzić, czy algorytm nie wykonuje setek tysięcy operacji, których można uniknąć.
Źródła i dalsza lektura
