Nadchodzące jądro Linux 7.4 otrzyma istotny pakiet zmian w podsystemie perf. Programiści pracujący nad rozwojem jądra przygotowali setki poprawek i usprawnień dotyczących profilowania procesora, analizy pamięci, śledzenia wywołań systemowych oraz diagnostyki wydajności.
Zmiany zostały zgłoszone przez Arnaldo Carvalho de Melo, jednego z głównych opiekunów narzędzi perf, a następnie zaakceptowane i włączone do głównego drzewa Linuksa przez Linusa Torvaldsa.
Najbardziej interesującą nowością jest rozszerzenie możliwości profilowania typów danych na architekturze ARM64. Oprócz tego przebudowano integrację z Pythonem, poprawiono analizę zdarzeń sprzętowych, dodano nowe funkcje diagnostyczne oraz usprawniono mechanizmy śledzenia procesów za pomocą eBPF.
Co dokładnie zmieni się w Linuksie 7.4? Przyjrzyjmy się najważniejszym elementom tego zestawu zmian.
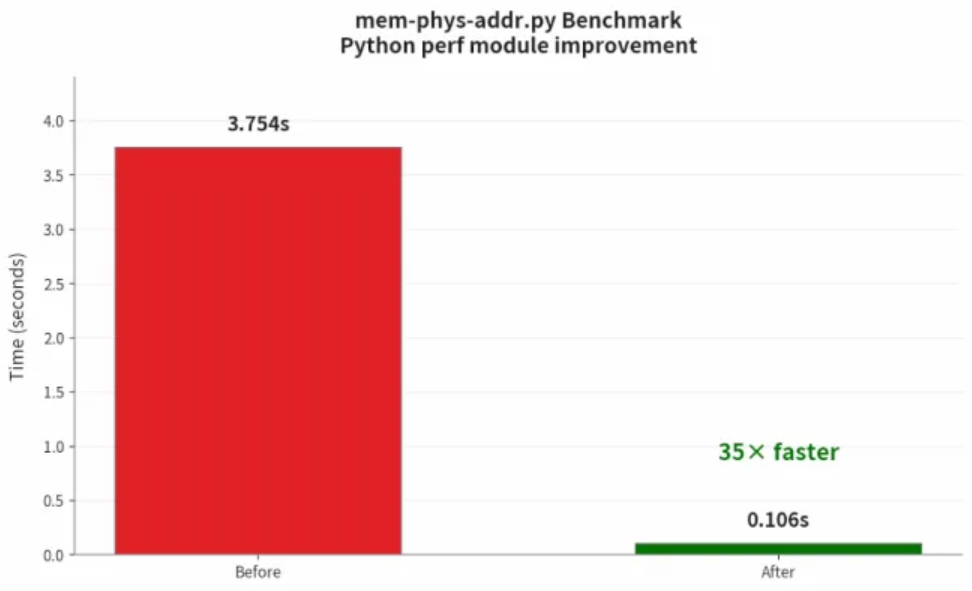
Linux 7.4 – zmiany w podsystemie perf
Na początek warto wyjaśnić, czym właściwie jest perf.
perf to zestaw narzędzi służących do profilowania i monitorowania wydajności systemów Linux. Pozwala analizować działanie procesora, pamięci operacyjnej, operacji wejścia/wyjścia, procesów i wątków, a także zdarzeń generowanych przez sprzęt oraz jądro systemowe.
Dzięki perf administratorzy i programiści mogą znaleźć odpowiedzi na pytania:
- Który proces najbardziej obciąża procesor?
- Jakie funkcje programu zużywają najwięcej czasu CPU?
- Dlaczego aplikacja wykonuje się wolniej niż oczekiwano?
- Które operacje powodują nadmierne wykorzystanie pamięci?
- Jak często występują błędy cache procesora?
- Które funkcje generują największą liczbę operacji?
- Jakie wywołania systemowe wykonuje analizowany proces?
W praktyce perf jest wykorzystywany zarówno przy optymalizacji aplikacji, jak i diagnozowaniu problemów z wydajnością serwerów, stacji roboczych czy systemów wbudowanych.
Pakiet zmian przygotowany dla Linux 7.4 obejmuje między innymi:
- obsługę profilowania typów danych na ARM64;
- przebudowę integracji z Pythonem;
- nowe eksportery danych do SQLite i PostgreSQL;
- rozwój generowania wykresów Flame Graph;
- usprawnienia perf trace i integracji z eBPF;
- poprawki analizy plików JITDump;
- dokładniejszą analizę pamięci procesora;
- nowy benchmark operacji atomowych;
- poprawki mechanizmów synchronizacji i konfiguracji;
- aktualizację danych dotyczących procesorów Intel;
- poprawki stabilności i bezpieczeństwa narzędzi.
Nie jest to więc pojedyncza funkcja, ale szeroka modernizacja całego ekosystemu perf.
1. ARM64 otrzymuje zaawansowane profilowanie typów danych
Jedną z najważniejszych zmian jest rozszerzenie obsługi profilowania typów danych na architekturze ARM64.
Dotychczas zaawansowane możliwości perf annotate --data-type były rozwijane przede wszystkim z myślą o architekturze x86. Nowe zmiany pozwalają przenieść podobne możliwości na procesory ARM64.
Dlaczego jest to ważne?
Samo profilowanie procesora informuje nas, które funkcje programu wykonują się najdłużej. Nie zawsze jednak pozwala ustalić, jakie operacje na danych odpowiadają za problem wydajnościowy.
Przykładowo aplikacja może wykonywać dużą liczbę operacji na strukturach przechowywanych w pamięci. Nieefektywne rozmieszczenie danych, częste odczytywanie określonych pól lub nieprawidłowa lokalizacja danych w cache procesora mogą znacząco obniżyć wydajność.
Właśnie tutaj przydaje się profilowanie typów danych.
Nowa implementacja dla ARM64 pozwala analizować dostęp do zmiennych przechowywanych w różnych obszarach pamięci:
- zmiennych lokalnych na stosie;
- zmiennych globalnych;
- zmiennych per-CPU;
- zmiennych związanych z aktualnie wykonywanym kontekstem, takich jak
current.
Szczególnie interesujące jest śledzenie instrukcji odczytu i zapisu.
Mechanizm analizuje instrukcje procesora, identyfikuje operacje na rejestrach oraz ustala, z jakimi obszarami pamięci mogą być związane.
Wykorzystuje do tego informacje debugowania DWARF, które pozwalają powiązać adresy i instrukcje maszynowe z typami danych znanymi z kodu źródłowego.
Dzięki temu perf annotate --data-type może prezentować informacje o typach danych również na ARM64, podobnie jak dotychczas robił to na x86.
Przykładowe użycie:
perf record -g ./moja-aplikacjaNastępnie analizujemy zebrane dane:
perf reportDo analizy typów danych służy:
perf annotate --data-typeWymaga to odpowiednich danych profilowania, obsługi danej architektury oraz dostępnych informacji debugowania. Nie każda aplikacja będzie więc automatycznie dostarczać pełny zestaw informacji.
Co to daje użytkownikom?
Przede wszystkim łatwiejsze wykrywanie problemów wydajnościowych w aplikacjach działających na serwerach ARM64, komputerach jednopłytkowych oraz innych urządzeniach korzystających z procesorów ARM.
Jest to istotne również w kontekście rosnącej popularności serwerów ARM w centrach danych.
2. Perf i Python – koniec starej integracji, nowe możliwości
Kolejnym dużym obszarem zmian jest integracja perf z Pythonem.
Do tej pory część skryptów Pythona była wykonywana za pośrednictwem mechanizmów osadzających interpreter Pythona bezpośrednio w narzędziu perf.
Takie rozwiązanie miało swoje ograniczenia związane z utrzymaniem, zależnościami oraz sposobem uruchamiania skryptów.
W Linux 7.4 rozwijany jest nowy model oparty na module perf oraz samodzielnym uruchamianiu skryptów.
Oznacza to odejście od starej integracji z biblioteką libpython i przeniesienie skryptów do bardziej elastycznej architektury.
Co się zmienia?
Przede wszystkim skrypty Pythona mogą być uruchamiane niezależnie, bez konieczności korzystania ze starego mechanizmu osadzonego interpretera.
Zmiana obejmuje również rozwój API udostępniającego dane profilowania.
Nowe możliwości obejmują między innymi:
- dostęp do informacji o stosie wywołań;
- analizowanie zdarzeń procesora;
- dostęp do informacji o wątkach i procesach;
- obsługę danych dotyczących przełączeń kontekstu;
- dostęp do informacji o lokalizacji adresów;
- obsługę zdarzeń Intel PT;
- analizowanie danych z sesji profilowania;
- eksportowanie wyników do zewnętrznych baz danych.
Ważną optymalizacją jest również leniwe przetwarzanie danych.
Zamiast natychmiast kopiować wszystkie próbki i informacje o stosach wywołań, perf może wykonywać te operacje dopiero wtedy, gdy rzeczywiście są potrzebne.
W przypadku dużych zbiorów danych oznacza to ograniczenie niepotrzebnych operacji kopiowania i potencjalnie mniejsze zużycie pamięci.
Obsługa GIL
Programiści poprawili również sposób współpracy z GIL (Global Interpreter Lock), czyli mechanizmem synchronizacji interpretera CPython.
Nowa implementacja pozwala zwalniać GIL podczas przetwarzania zdarzeń sesji perf.
Jest to istotne, ponieważ długotrwałe przetwarzanie danych profilowania nie musi w każdej sytuacji blokować innych operacji wykonywanych przez interpreter.
Warto zaznaczyć, że zwalnianie GIL nie oznacza automatycznego przyspieszenia każdego skryptu. Korzyści zależą od sposobu jego napisania i rodzaju wykonywanych operacji.
Nowe eksportery SQLite i PostgreSQL
Jedną z najbardziej praktycznych zmian jest rozwój eksporterów danych do baz SQL.
W nowym zestawie zmian przeniesiono do modułu perf obsługę eksportowania wyników do:
- SQLite;
- PostgreSQL.
Dzięki temu dane profilowania można przechowywać w bazach danych, analizować za pomocą zapytań SQL i łączyć z innymi systemami monitorowania.
To szczególnie przydatne podczas długoterminowej analizy wydajności.
Przykładowo administrator może zbierać dane z wielu serwerów, przechowywać je w bazie PostgreSQL i porównywać zachowanie aplikacji w różnych okresach.
3. Flame Graph – łatwiejsze analizowanie stosów wywołań
Kolejnym obszarem rozwoju jest obsługa Flame Graph, czyli wykresów płomieniowych.
To jedna z najbardziej czytelnych metod przedstawiania informacji o wykorzystaniu procesora przez poszczególne funkcje programu.
Flame Graph pozwala zobaczyć, które funkcje i ścieżki wywołań zajmują najwięcej czasu podczas działania aplikacji.
Wizualizacja ma postać poziomych prostokątów:
- szerokość prostokąta odpowiada udziałowi danej funkcji w zebranych próbkach;
- wysokość pokazuje poziom zagnieżdżenia wywołań;
- kolejne poziomy przedstawiają relacje pomiędzy funkcjami.
Przykładowo, jeżeli jedna funkcja zajmuje bardzo dużą część wykresu, może być dobrym miejscem do rozpoczęcia optymalizacji.
Nowe zmiany rozwijają obsługę Flame Graph w ekosystemie Pythona i ułatwiają tworzenie raportów na podstawie danych z perf.
To szczególnie interesujące dla programistów C, C++, Rust oraz innych języków, w których wydajność kodu ma duże znaczenie.
4. Perf trace i eBPF – dokładniejsze śledzenie procesów
Istotne usprawnienia otrzymuje również perf trace.
Jest to narzędzie służące do analizowania wywołań systemowych i zdarzeń związanych z wykonywaniem procesów.
Pozwala obserwować między innymi:
- otwieranie plików;
- operacje odczytu i zapisu;
- tworzenie procesów;
- komunikację z jądrem;
- operacje sieciowe;
- wywołania systemowe wykonywane przez aplikacje.
Nowe zmiany dotyczą przede wszystkim integracji z eBPF.
eBPF umożliwia wykonywanie specjalnych programów w jądrze Linux, które mogą obserwować zdarzenia systemowe i zbierać informacje bez konieczności modyfikowania samego jądra.
W Linux 7.4 poprawiono sposób filtrowania zdarzeń dotyczących procesów.
Filtrowanie zadań za pomocą BPF
Jedną z nowości jest przeniesienie filtrowania zadań należących do analizowanego procesu do programu BPF.
Oznacza to, że niepotrzebne zdarzenia mogą zostać odrzucone już na poziomie mechanizmu śledzącego.
Zamiast zbierać dużą liczbę zdarzeń, a następnie odrzucać je dopiero w przestrzeni użytkownika, można ograniczyć ich przetwarzanie wcześniej.
To ma znaczenie szczególnie na systemach generujących dużą liczbę zdarzeń.
Obsługa wyjściowych zdarzeń BPF na wszystkich CPU
Kolejna zmiana dotyczy otwierania zdarzenia wyjściowego BPF na każdym procesorze.
Poprawia to obsługę zbierania danych w środowiskach wieloprocesorowych.
Dzięki temu mechanizm może prawidłowo współpracować z systemami, w których analizowane procesy przemieszczają się pomiędzy rdzeniami.
Opcja wyłączenia syscall augmentation
Dodano również możliwość wyłączenia mechanizmu syscall augmentation.
Funkcja ta odpowiada za rozszerzanie informacji o wywołaniach systemowych o dodatkowe dane.
Nie zawsze potrzebujemy tak szczegółowego opisu. W niektórych scenariuszach wystarczy sama informacja o wywołaniu systemowym i jego czasie wykonania.
Możliwość wyłączenia dodatkowego wzbogacania danych daje większą kontrolę nad zakresem zbieranych informacji.
Zwiększono także limit TRACE_AUG_MAX_BUF do 128, co pozwala obsługiwać większe bufory danych wykorzystywanych podczas rozszerzania informacji o zdarzeniach.
5. JITDump – poprawione bezpieczeństwo i analiza kodu generowanego dynamicznie
Linux 7.4 przynosi również poprawki dotyczące JITDump.
JITDump to format wykorzystywany przez środowiska uruchomieniowe i narzędzia JIT do przekazywania informacji o kodzie generowanym dynamicznie.
Ma to znaczenie między innymi dla aplikacji wykorzystujących:
- Java Virtual Machine;
- silniki JavaScript;
- środowiska uruchomieniowe generujące kod maszynowy;
- biblioteki JIT;
- dynamiczne kompilatory.
Problem polega na tym, że tradycyjne profilery często mają trudności z analizowaniem kodu, który nie istnieje w postaci klasycznego pliku wykonywalnego.
Kod JIT może być tworzony podczas działania programu, a jego adresy i symbole muszą zostać odpowiednio udostępnione narzędziom diagnostycznym.
Nowe poprawki koncentrują się na bezpieczniejszym przetwarzaniu rekordów JITDump.
Obejmują między innymi:
- walidację rozmiarów danych związanych z unwindingiem;
- kontrolę nazw symboli;
- bezpieczniejszą obsługę wpisów debugowania;
- poprawne uwzględnianie kolejności bajtów;
- naprawienie wycieków pamięci w ścieżkach błędów.
Szczególnie ważna jest walidacja danych wejściowych.
Nieprawidłowe rozmiary rekordów lub błędne informacje o symbolach mogą prowadzić do błędów podczas analizowania plików.
Nowe mechanizmy ograniczają ryzyko nieprawidłowego przetwarzania takich danych.
Dla użytkowników oznacza to bardziej niezawodną analizę aplikacji wykorzystujących dynamiczne generowanie kodu.
6. Dokładniejsza analiza pamięci procesora
Ważne zmiany dotyczą również polecenia:
perf memNarzędzie to służy do profilowania operacji związanych z pamięcią i analizowania zachowania procesora podczas dostępu do danych.
W nowym zestawie zmian pojawia się między innymi domyślne żądanie PERF_SAMPLE_CPU.
Dzięki temu zbierane próbki zawierają informację o procesorze, na którym wystąpiło dane zdarzenie.
Jest to przydatne w analizie systemów wielordzeniowych i procesorów o architekturze hybrydowej.
Obsługa Intel IBS
Dodano również wykorzystanie filtra swfilt w AMD IBS, jeżeli jest on dostępny.
IBS (Instruction Based Sampling) to mechanizm sprzętowego profilowania dostępny w wybranych procesorach AMD.
Pozwala zbierać szczegółowe informacje dotyczące wykonywania instrukcji oraz operacji związanych z pamięcią.
Wykorzystanie odpowiedniego filtra może poprawić jakość zbieranych danych i ograniczyć wpływ niepożądanych próbek.
Nowy poziom pamięci L0
Kolejną nowością jest dekodowanie poziomu pamięci L0.
W praktyce oznacza to rozszerzenie interpretacji informacji o lokalizacji danych w hierarchii pamięci procesora.
Ma to znaczenie dla dokładniejszego analizowania zachowania pamięci podręcznych i identyfikowania potencjalnych wąskich gardeł.
Wprowadzono także poprawki w perf c2c oraz perf script, które pozwalają prezentować informacje o regionach pamięci.
Dzięki temu analiza danych nie ogranicza się wyłącznie do informacji o funkcjach i adresach, ale może dostarczać dodatkowego kontekstu dotyczącego analizowanych obszarów pamięci.
7. False Sharing – nowy scenariusz testowy
Jedną z ciekawszych nowości jest dodanie testowego scenariusza false sharing do:
perf testFalse sharing to problem związany z architekturą pamięci podręcznej procesorów wielordzeniowych.
Występuje wtedy, gdy różne rdzenie modyfikują niezależne zmienne znajdujące się w tej samej linii cache.
Chociaż programiści mogą pracować na zupełnie różnych zmiennych, sprzętowy mechanizm koherencji cache traktuje całą linię jako jednostkę synchronizacji.
W rezultacie aktualizowanie jednej zmiennej może powodować konieczność synchronizowania danych pomiędzy rdzeniami.
To może znacząco obniżyć wydajność aplikacji wielowątkowych.
Przykładowo dwa wątki mogą modyfikować różne liczniki:
struct counters {
    long thread1_counter;
    long thread2_counter;
};
Jeżeli obie zmienne znajdują się w tej samej linii cache, ich niezależne aktualizowanie może powodować niepotrzebny ruch związany z koherencją pamięci podręcznej.
Nowy scenariusz testowy pozwala odtworzyć taki problem i wykorzystać perf do obserwowania jego skutków.
Jest to szczególnie przydatne dla programistów aplikacji wielowątkowych, systemów bazodanowych i oprogramowania serwerowego.
8. Nowy benchmark operacji atomowych
W zestawie zmian znalazł się również nowy benchmark:
perf bench atomicJego zadaniem jest testowanie wydajności operacji atomowych.
Operacje atomowe to specjalne operacje wykonywane w sposób niepodzielny z punktu widzenia innych wątków.
Są wykorzystywane między innymi przy:
- synchronizacji wątków;
- zarządzaniu licznikami;
- implementacji blokad;
- strukturach danych współdzielonych;
- mechanizmach komunikacji międzyprocesowej.
Nowy benchmark pozwala badać zachowanie operacji atomowych i porównywać ich wydajność w różnych konfiguracjach sprzętowych.
Ma to znaczenie dla osób rozwijających jądro Linux, biblioteki systemowe oraz oprogramowanie intensywnie wykorzystujące wielowątkowość.
9. Intel PMU – aktualizacja danych o procesorach
Kolejny obszar zmian dotyczy danych o jednostkach monitorowania wydajności Intel PMU.
PMU (Performance Monitoring Unit) to sprzętowy mechanizm pozwalający monitorować zdarzenia zachodzące wewnątrz procesora.
Może dostarczać informacji o:
- wykonanych instrukcjach;
- cyklach procesora;
- błędach cache;
- operacjach pamięci;
- przewidywaniu skoków;
- wykorzystaniu określonych jednostek wykonawczych.
W Linux 7.4 zaktualizowano tabele zdarzeń i metryk dla wielu generacji procesorów Intel.
Zmiany obejmują między innymi Alder Lake, Arrow Lake, Broadwell, Cascade Lake, Emerald Rapids, Granite Rapids, Meteor Lake, Nova Lake, Panther Lake i Sapphire Rapids.
Zaktualizowano również metryki Intel Top-Down Microarchitecture Analysis (TMA) do wersji 5.2 dla odpowiednich platform.
Dla użytkowników perf oznacza to dokładniejsze dane wykorzystywane podczas analizy wydajności procesorów.
Jest to szczególnie ważne w przypadku nowoczesnych procesorów hybrydowych, które łączą różne typy rdzeni.
10. Perf report otrzymuje pasek postępu
Zmiany obejmują również interfejs tekstowy narzędzia:
perf reportDodano dwie opcje:
perf report --progressoraz:
perf report --no-progressPierwsza pozwala wyświetlać informację o postępie przetwarzania danych, druga wyłącza ten mechanizm.
Może to być przydatne podczas analizowania dużych plików perf.data, kiedy przetwarzanie próbek i generowanie raportów zajmuje więcej czasu.
To niewielka zmiana, ale poprawiająca wygodę codziennej pracy.
11. GTK 4 – dalsza modernizacja interfejsu graficznego
W pakiecie zmian znalazła się także aktualizacja interfejsu graficznego perf.
Przeniesiono interfejs z GTK 2 do GTK 4.
Jest to ważny krok modernizacyjny, ponieważ GTK 2 jest już przestarzałą generacją biblioteki graficznej.
GTK 4 oferuje nowocześniejszą architekturę, rozwijane mechanizmy renderowania i lepsze wsparcie dla współczesnych środowisk graficznych.
Poprawiono również działanie przeglądarki raportów opartej na GTK 4 oraz usunięto błędy związane z przepełnieniami bufora stosu w widokach hierarchicznych.
Dzięki temu graficzna część perf staje się bardziej aktualna technologicznie.
12. Lepsze zarządzanie konfiguracją i synchronizacja nagłówków
Warto wspomnieć również o zmianach technicznych, które nie są bezpośrednio widoczne dla użytkownika.
Przebudowano mechanizmy dostępu do plików konfiguracyjnych perf.
Dodano między innymi:
- synchronizację dostępu do konfiguracji za pomocą mutexów;
- mechanizm
DEFINE_MUTEX(); - mechanizm
DO_ONCE()do wykonywania inicjalizacji tylko raz; - obsługę współdzielonych mutexów między procesami.
Poprawki te mają znaczenie dla bezpieczeństwa i prawidłowego działania kodu w środowiskach wielowątkowych oraz wieloprocesowych.
Dodano także skrypt i cel Makefile:
make sync-headersJego zadaniem jest synchronizowanie kopii nagłówków jądra wykorzystywanych przez narzędzia z właściwymi nagłówkami źródłowymi.
To ważne, ponieważ narzędzia z katalogu tools/ korzystają z kopii wybranych nagłówków jądra.
Jeżeli kopie te nie są aktualizowane, mogą pojawić się rozbieżności pomiędzy interfejsami wykorzystywanymi przez narzędzia a aktualnym kodem jądra.
Nowy mechanizm ma ułatwić utrzymywanie ich w zgodności.
Kiedy zmiany trafią do użytkowników?
Opisywany zestaw zmian został przygotowany dla cyklu rozwojowego Linux 7.4.
Merge request został zaakceptowany przez Linusa Torvaldsa 30 października 2026 roku.
W głównym repozytorium Linuksa zmiany znajdują się w commicie scalającym:
dd384658c738d15783a786d3af2851e02490f171Sam zestaw zmian pochodzi z gałęzi:
perf-tools-for-v7.4-1-2026-10-30Warto podkreślić, że większość opisanych usprawnień dotyczy narzędzi perf znajdujących się w drzewie źródłowym jądra, a nie bezpośrednio mechanizmów wykonywania procesów przez jądro.
Oznacza to, że część nowych funkcji może być dostępna po zbudowaniu i zainstalowaniu odpowiedniej wersji narzędzia perf, nawet jeśli użytkownik nie korzysta jeszcze z finalnego wydania jądra 7.4. Ostateczna dostępność zależy od wersji pakietu perf dostarczanego przez daną dystrybucję.
Podsumowanie – Linux 7.4 coraz mocniejszy w diagnostyce wydajności
Zmiany przygotowane dla podsystemu perf pokazują, że rozwój Linuksa nie koncentruje się wyłącznie na nowych sterownikach, obsłudze sprzętu czy poprawkach systemu plików.
Równie ważne jest rozwijanie narzędzi, które pozwalają lepiej zrozumieć, co dzieje się wewnątrz systemu.
Szczególnie interesujące są nowe możliwości profilowania typów danych na ARM64. To ważny krok dla rozwoju diagnostyki wydajności na serwerach i urządzeniach wykorzystujących procesory ARM.
Na uwagę zasługuje także modernizacja integracji z Pythonem, która ułatwi tworzenie własnych analizatorów i eksportowanie danych do baz SQLite oraz PostgreSQL.
Nie można zapominać o poprawkach eBPF, analizie pamięci, nowym benchmarku operacji atomowych oraz obsłudze false sharing.
Linux 7.4 zapowiada się jako ważne wydanie dla programistów, administratorów i osób zajmujących się optymalizacją systemów. Nowości w perf nie zmienią bezpośrednio szybkości działania każdego komputera, ale dostarczą znacznie lepszych narzędzi do wykrywania i rozwiązywania problemów wydajnościowych.
A to właśnie dokładna diagnostyka jest często pierwszym krokiem do stworzenia szybszego i bardziej stabilnego oprogramowania.
